AI 生圖角色臉一直變?拿 CC0 參考臉實測固定長相
想讓 AI 角色在不同場景都長同一張臉,光靠提示詞做不到。我們從 CC0 圖庫 Face Reference 挑一張臉,用 Qwen-Image-Edit-2511 實測四個場景,並附上 Nano Banana、Midjourney 的參考圖用法。
你想要的是圖庫裡那個齊瀏海、笑起來會露牙齒的女生,AI 給你的是它心中的「標準日本女生」。而且不管你怎麼改提示詞,大概都是她。
這就是 AI 生圖的「角色一致性」問題。單張圖好看很簡單,要讓你挑中的那張臉出現在咖啡廳、捷運、海邊,光靠文字描述幾乎不可能。現在主流工具的做法都一樣:丟一張參考臉進去,臉交給圖,文字只管場景和動作。
講了這麼多,我們直接在 RTX 5090 上實際跑一次。
參考臉從哪來:CC0 圖庫挑一張正面臉
參考臉要正面、光線平均、背景乾淨、解析度夠。不要用真人照片,同事、網紅、明星都不行,肖像權和深偽爭議很難收拾。
這次用的是這週剛紅起來的日本圖庫 Face Reference,它的臉部區有 893 張正面照,CC0 授權,可以商用。我們從「ショート」(短髮)分類挑了一張檔名 f71f980dde3 的原尺寸 PNG,1122×1402 像素。作者拜託大家不要轉傳原圖,所以本文只放裁切過的示意,想用請到官網下載。
先看沒給參考圖會怎樣
對照組:用不能吃參考圖的 Qwen-Image 2512,提示詞只寫「一位短髮的年輕日本女性」,再加上捷運和咖啡廳兩個場景的描述。
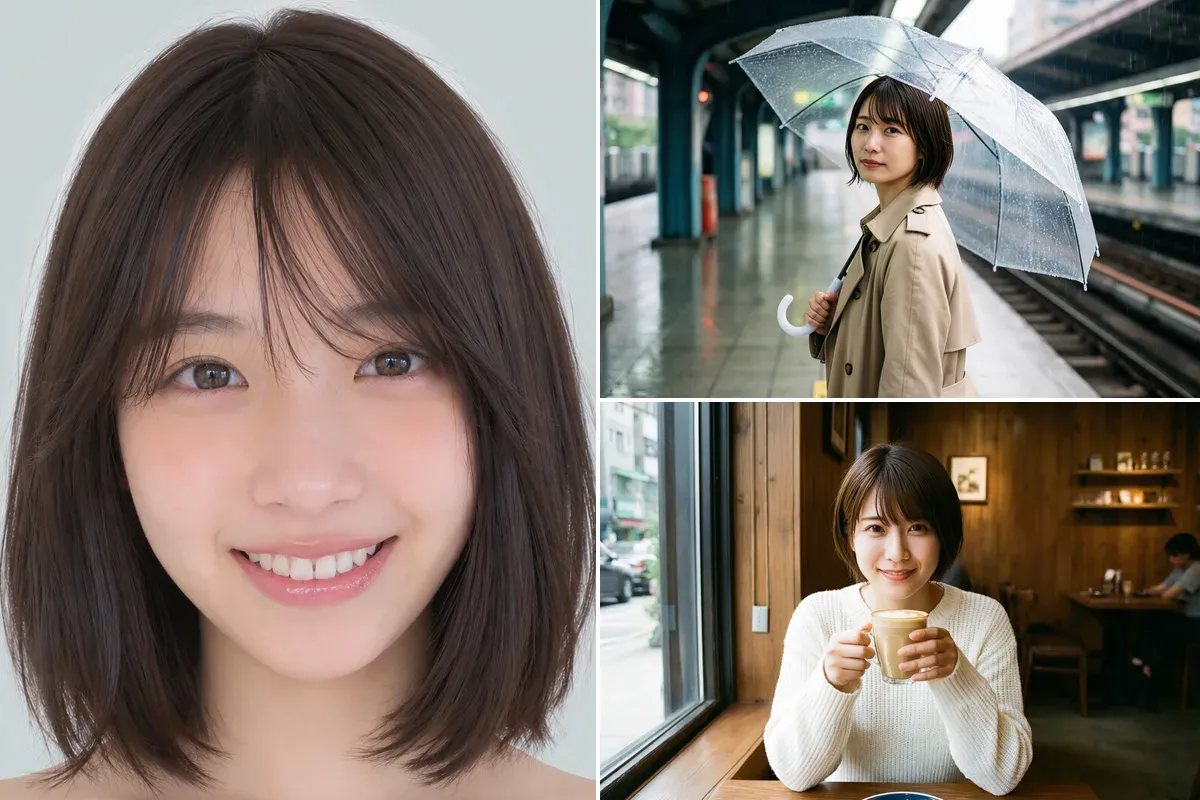
結果有點出乎意料:右邊兩張其實長得挺像,同一段描述換 seed 也是差不多那張臉。Qwen-Image 心裡有一張預設的短髮日本女生。
問題是,那是它的臉,不是你挑的。左邊的參考臉齊瀏海、頭髮到下巴以下、笑的時候露牙,右邊兩張的頭髮短一截、笑法也不一樣。你在提示詞裡寫再多「齊瀏海、大眼睛、露齒笑」,也只能把預設臉往那個方向推一點點。
實測:Qwen-Image-Edit-2511 四個場景同一張臉
換成阿里巴巴的 Qwen-Image-Edit-2511。它是 Apache 2.0 授權,可以商用,2511 版的更新重點就是角色一致性。
ComfyUI 裡的接法:
LoadImage讀參考臉,接ImageScaleToTotalPixels縮到約 100 萬像素- 正向、反向兩個
TextEncodeQwenImageEditPlus的image1都接這張參考圖,反向提示詞留空 - 想要不同構圖,latent 用
EmptySD3LatentImage開一張新的 1584×1056,不要拿參考圖去 encode - KSampler 40 步、cfg 4、euler/simple
提示詞直接寫中文。四張只差在場景,結尾都加同一句:
保持她的臉型、五官、眼睛和髮型完全不變。寫實照片風格,自然光。
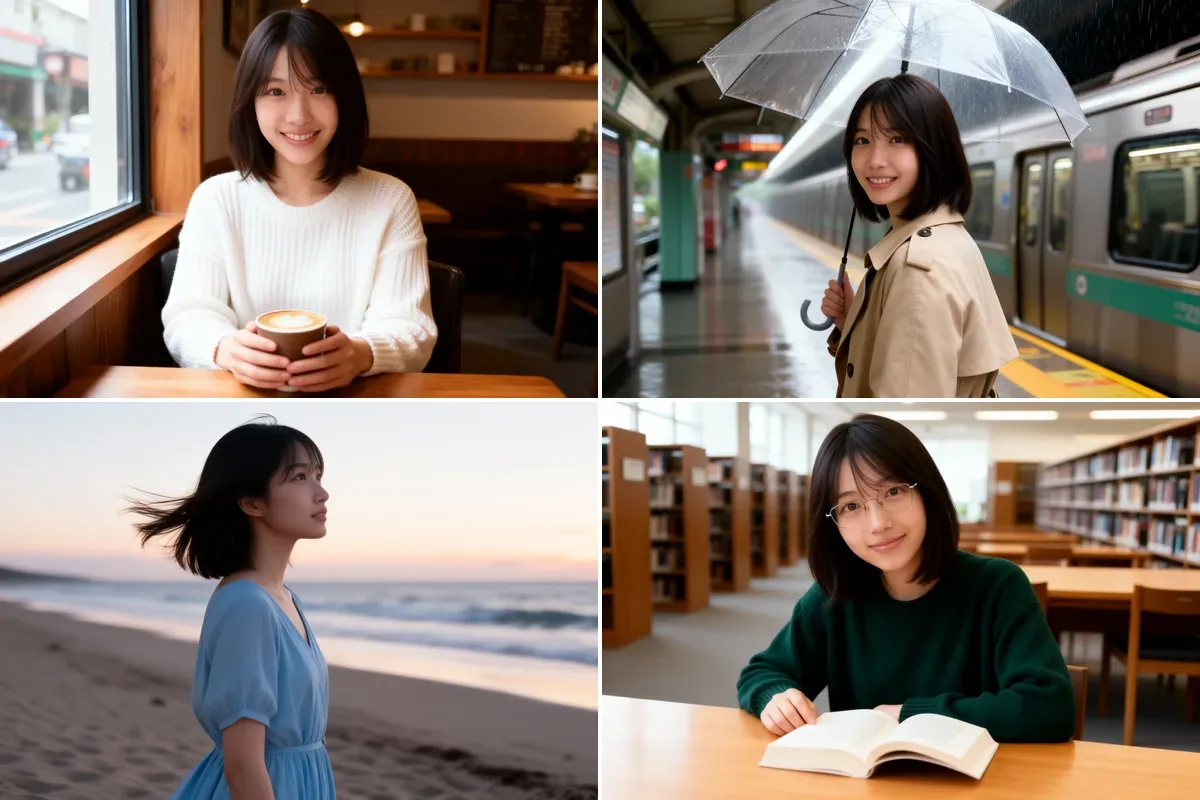
四張的瀏海、髮長、露齒笑都留住了,連戴上眼鏡的圖書館那張都認得出是同一個人。海邊那張是側臉,比較難比對,但髮型和輪廓沒有跑掉。
小瑕疵也有:捷運那張的車廂和站牌上出現了看不懂的假文字,這是生圖模型的老毛病,正式使用前要修掉或裁掉。
速度方面,在 RTX 5090 上用 fp8 版本,一張 1584×1056 的圖要 131 到 154 秒。同解析度、同樣 40 步的純文字生圖大約 65 秒,所以吃參考圖差不多慢一倍。社群另外有 8 步的 Lightning 加速 LoRA,快很多,但我們之前用它改構圖常常失敗,要鎖臉的話建議還是跑完整 40 步。
它是 200 億參數的模型,顯示卡記憶體不夠大的話,要找量化過的版本,不然光載入就卡住。
不想自己跑:Nano Banana Pro 和 Midjourney
沒有大顯卡的話,Google 的 Nano Banana Pro(Gemini 3 Pro Image)最好上手,Gemini App 直接上傳圖片就能用。Google 官方說它最多可以混合 14 張參考圖,並維持最多 5 個人的長相一致。上面那句「保持她的臉型、五官不變」的寫法一樣適用;雙人場景就上傳兩張臉,寫明「第一張圖的女性」「第二張圖的女性」各自在做什麼,不要寫「她們」,模型很容易把兩張臉混在一起。
Midjourney 用的是 Omni Reference:網頁版把圖拖進 Imagine 列的參考欄位,Discord 則在提示詞最後加 --oref 圖片網址。強度用 --ow 調,範圍 1 到 1000,預設 100,官方建議除非 stylize 開很高,不然不要超過 400。官方文件也寫明 Omni Reference 只能在 V7 用,V8.2 另外有新的編輯模型,用法不同,用之前先看官方版本說明。
最常踩的坑
**提示詞又描述一次臉。**參考圖負責臉,文字就別再寫「大眼睛、尖下巴」,兩邊打架,模型會折衷出第三張臉。
**參考圖一直換。**今天用這張、明天用另一張「很像的」,角色還是會飄。挑定一張,把檔名記下來,這也是 Face Reference 官網給的建議。
**以為 CC0 就萬無一失。**CC0 只代表參考圖本身沒有著作權問題。生出來的臉如果剛好很像某位藝人,或你拿去開假帳號、做假見證,責任都在你身上。寫實風格的 AI 人像發到社群時,最好主動標示是 AI 生成。